
Um Small Language Model (SLM) é um modelo de inteligência artificial compacto. Ele tem entre um e quinze bilhões de parâmetros e resolve tarefas com rapidez. Empresas usam esses modelos pequenos para cortar custos de nuvem e proteger dados pela LGPD.
Essa estrutura enxuta reduz gastos logo no primeiro mês. O sistema roda direto em computadores comuns e servidores locais. Ele não depende de conexão contínua com a internet para funcionar.
O que muda entre um modelo pequeno e um modelo gigante de inteligência artificial?
Um modelo gigante tenta saber sobre tudo no mundo. Já o modelo pequeno foca em resolver tarefas da sua empresa com velocidade e baixo custo. A diferença prática está no consumo de memória e no valor da conta mensal.
Pense no transporte de carga de uma empresa. Um modelo gigante funciona como uma carreta de carga pesada. Ela leva muito peso, mas gasta muito combustível e custa caro para rodar.
Contratar essa carreta para levar um envelope no centro da cidade é jogar dinheiro fora. O modelo pequeno funciona como uma moto de entrega. Ela gasta pouco combustível, foge do trânsito e entrega a encomenda na metade do tempo.
Pesquisadores da Microsoft comprovaram essa economia no estudo Textbooks Are All You Need e no relatório do modelo compacto Phi-3. Quando o treino usa dados de alto nível didático, modelos leves superam sistemas muito maiores em tarefas de rotina.
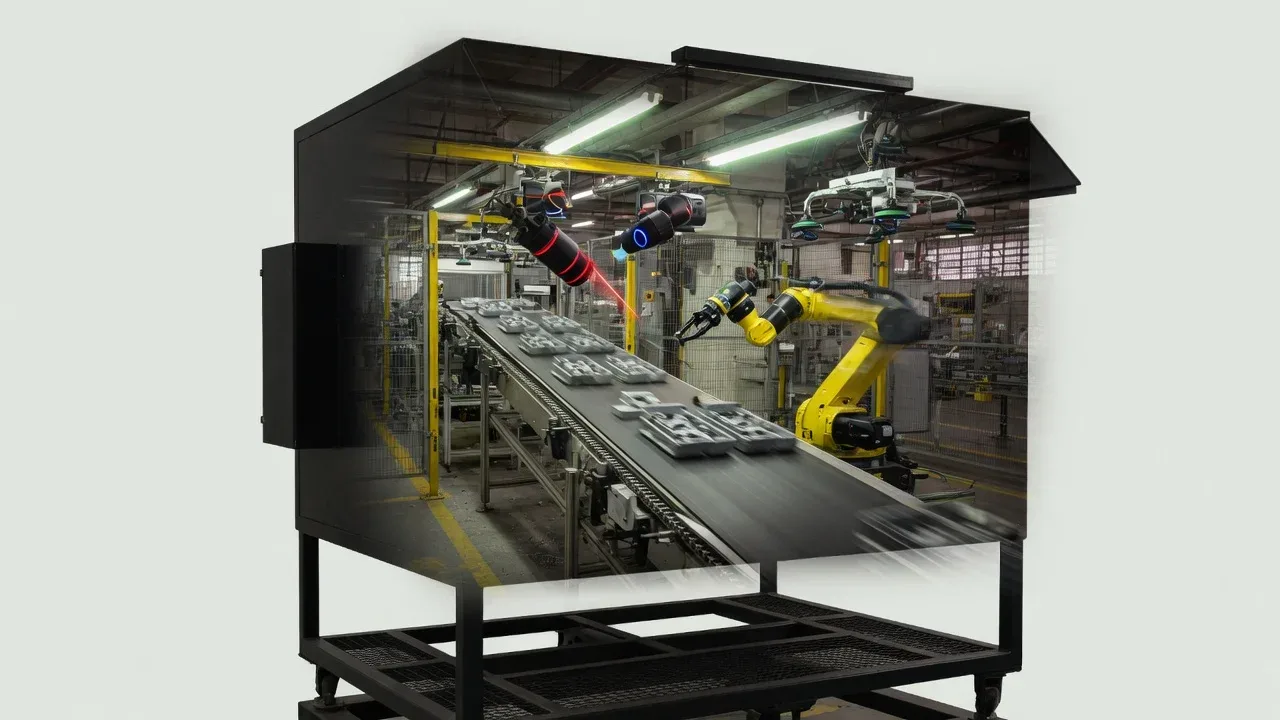
Por que rodar um modelo compacto dentro da própria empresa?
Rodar um modelo dentro da empresa protege os dados de clientes e corta faturas de nuvem. Os arquivos nunca saem da sua rede interna, o que cumpre as regras da LGPD sem riscos jurídicos.
Essa escolha traz três vantagens diretas para o seu negócio:
- Sigilo total e segurança jurídica: Em clínicas, escritórios de advocacia e contabilidade, enviar dados para fora cria risco de vazamento. O modelo local roda isolado da internet pública.
- Custo fixo e previsível: A fatura de nuvem externa sobe quando o movimento de clientes cresce. O modelo local tem custo fixo e usa máquinas já presentes na empresa.
- Velocidade e trabalho sem internet: A resposta surge na tela em frações de segundo. Se a conexão externa cair no prédio, o caixa e o estoque continuam operando normalmente.
A Meta comprovou essa agilidade ao lançar o Llama 3.2 para aparelhos portáteis. O sistema foi feito para rodar com rapidez em notebooks e servidores de escritório.
Quais são os principais modelos pequenos disponíveis no mercado?
Os principais modelos pequenos do mercado entendem português com clareza e rodam em máquinas comuns sem exigir placas de vídeo caras.
Os modelos de maior destaque para o mercado corporativo são:
- Microsoft Phi-4 e Phi-3.5: Feitos pela Microsoft Research com foco em matemática e lógica, como mostra o relatório técnico do Phi-4. Eles validam regras de negócio com rigor em computadores normais.
- Meta Llama 3.2 de um e três bilhões: Feitos para rodar em celulares e computadores de mesa. Eles ocupam pouca memória e leem textos longos com agilidade.
- Google Gemma 2 de dois e nove bilhões: Criados pela equipe do Google DeepMind e descritos em estudo formal sobre modelos eficientes. Eles usam o saber de sistemas maiores para gerar textos claros.
- Alibaba Qwen 2.5: Apresentados no relatório técnico da família Qwen com ótima fluência em português. Eles se destacam ao extrair dados de tabelas e preencher sistemas internos.
Qual a diferença prática entre modelos compactos, gigantes e analíticos?
A escolha entre modelos compactos, gigantes e analíticos depende da velocidade desejada, do orçamento da área e do sigilo do processo.
A tabela abaixo resume a função de cada tecnologia no dia a dia da empresa:
| Ponto de análise | Modelo Pequeno (como Llama 3.2 e Phi-4) | Modelo Gigante (como GPT-4o e Claude 3.5) | Modelo de Raciocínio (como o1 e R1) |
|---|---|---|---|
| Onde o sistema roda | Computador local ou servidor da empresa | Centros de dados em nuvem de terceiros | Servidores de nuvem de grande porte |
| Tempo de resposta | Menos de um segundo | De um a dois segundos | De cinco a quarenta segundos |
| Custo de operação | Muito baixo e com valor fixo | Cobrado por volume de palavras lidas e geradas | Alto, cobrando o rascunho de pensamento |
| Sigilo dos dados | Total, sem saída de dados para fora | Depende de contratos com provedores | Depende de contratos com provedores |
| Melhor aplicação | Triagem de chamados e leitura de notas | Redação aberta e resumos amplos | Auditoria de contratos e contas difíceis |
Essa separação ajuda a sua equipe a investir no lugar certo, sem pagar caro por tarefas simples de escritório.
Quando vale a pena adotar um modelo compacto na sua empresa?
Vale a pena adotar um modelo compacto quando a empresa tem tarefas repetitivas, grande volume diário e necessidade de sigilo. Se a meta é ter respostas rápidas e custos sob controle, o modelo pequeno é o caminho ideal.
Os melhores pontos de início na rotina da empresa são:
- Triagem de suporte: ler mensagens de clientes e mandar para o setor certo em frações de segundo.
- Leitura de notas fiscais: extrair valores e dados de faturas para preencher o sistema sem digitação manual.
- Resumo de conversas: salvar os pontos centrais de atendimentos direto no sistema de vendas.
- Operação em lojas e balcões: manter pedidos e consulta de estoque funcionando mesmo sem sinal de internet.
O passo mais seguro para começar é escolher uma tarefa repetitiva. Instale um modelo compacto em teste e meça o ganho real de tempo da equipe.
Perguntas Frequentes sobre Small Language Models
O que é um Small Language Model e qual sua diferença para um LLM?
Um Small Language Model é um sistema de inteligência artificial compacto com até quinze bilhões de parâmetros, contra centenas de bilhões de um LLM comum. Enquanto o modelo gigante atua como enciclopédia geral na nuvem, o modelo pequeno foca em tarefas pontuais com rapidez e baixo consumo de energia. Essa estrutura permite treinar o sistema para rotinas da empresa com a mesma precisão dos modelos maiores.
Por que empresas escolhem modelos pequenos em vez de serviços de nuvem?
Empresas escolhem modelos pequenos por economia de gastos, proteção de dados e velocidade de resposta. A execução em máquinas próprias reduz em até noventa por cento os gastos com assinaturas externas. Além disso, os documentos da empresa ficam protegidos na rede interna, o que cumpre as regras da LGPD e evita vazamento de dados estratégicos.
É possível rodar um modelo pequeno sem conexão com a internet?
Sim, modelos compactos modernos rodam de forma cem por cento offline em computadores normais de escritório ou servidores locais. Quando convertidos para formatos leves, eles ocupam de dois a quatro gigabytes de memória, operando com agilidade em notebooks comuns. Isso garante que lojas, fábricas e escritórios continuem atendendo clientes mesmo em quedas de sinal de internet.
Um modelo pequeno consegue ser tão preciso quanto um modelo gigante?
Sim, um modelo compacto ajustado para regras da sua empresa supera modelos gigantes generalistas em tarefas de rotina. Como não carrega dados extras de cultura pop ou curiosidades gerais, ele foca estritamente nas regras do seu negócio. Em tarefas como leitura de notas, triagem de chamados e preenchimento de cadastros, o modelo especialista é mais direto e confiável.
