
Função de perda em inteligência artificial é a fórmula matemática que quantifica o erro entre a previsão do modelo e o valor real. Ela avalia uma amostra por vez. Converte esse desvio em um valor numérico que orienta o treinamento. Quanto menor a perda, mais precisa é a resposta do modelo.
Sem uma função de perda, a rede neural não aprende. O modelo não saberia para onde ajustar seus pesos sinápticos. Essa função atua como bússola matemática em todo o aprendizado de máquina.
A Diferença Entre Função de Perda, Função de Custo e Métrica de Avaliação
Função de perda calcula o erro de uma única amostra de treino. Função de custo calcula a média dessas perdas sobre o lote ou dataset completo. Já a métrica de avaliação mede o sucesso do negócio e não precisa ser derivável.
Essa distinção evita erros graves na arquitetura de código. A perda pontual é escrita como L(y, ŷ). Ela avalia apenas um exemplo isolado.
Por outro lado, a função de custo agrega todas as perdas do lote. Sua equação padrão é J(θ) = (1 ÷ N) × Σ L_i. Ela representa o erro médio do modelo.
| Conceito | Escopo de Aplicação | Requisito Matemático | Exemplo Comum |
|---|---|---|---|
| Função de Perda (Loss) | Uma única amostra individual | Precisa ser contínua e diferenciável | (y - ŷ)^2 para um registro |
| Função de Custo (Cost) | Média sobre o lote ou dataset | Derivável em relação aos pesos | MSE médio ou Cross-Entropy do batch |
| Métrica de Avaliação | Negócio e validação humana | Não precisa de derivadas | Acurácia, F1-Score, BLEU, ROC-AUC |
Métricas de negócio não servem para treinar a rede diretamente. A acurácia, por exemplo, varia em saltos discretos e tem derivada nula em quase todo ponto. Se usássemos acurácia como perda, o gradiente seria zero e os parâmetros não mudariam.
Funções de Perda para Problemas de Regressão: MSE, MAE e Huber Loss
Funções de perda para regressão medem distâncias numéricas entre previsões contínuas e valores reais observados. O Mean Squared Error penaliza desvios grandes de forma quadrática. O Mean Absolute Error responde de modo linear, enquanto a Huber Loss une suavidade e robustez.
A base teórica do erro quadrático remonta a Adrien-Marie Legendre (1805). O método foi ampliado por Carl Friedrich Gauss (1809). Gauss provou que minimizar resíduos quadráticos equivale à estimativa de máxima verossimilhança quando os ruídos seguem uma distribuição normal.
Mean Squared Error (MSE / Perda L2)
O MSE eleva a diferença entre o valor real e a previsão ao quadrado: L_MSE = (y - ŷ)^2. Ao elevar ao quadrado, desvios grandes recebem punições desproporcionais.
Um erro de 10 unidades gera uma penalidade cem vezes maior do que um erro de 1 unidade. Essa característica acelera a convergência em dados limpos.
Sua derivada é contínua e linear. Ela guia os pesos de forma estável até o ponto de mínimo. A fraqueza do MSE é sua sensibilidade extrema a dados discrepantes. Um único outlier corrompido pode desviar todo o aprendizado.
Mean Absolute Error (MAE / Perda L1)
O MAE utiliza o módulo da diferença linear: L_MAE = |y - ŷ|. Ele trata desvios pequenos e grandes com a mesma proporção.
Um erro de 10 unidades recebe exatamente dez vezes a punição de um erro unitário. Essa resposta linear confere alta robustez contra ruídos e anomalias.
O desafio do MAE reside no seu gradiente. Sua derivada é constante (+1 ou -1), mantendo o mesmo impulso mesmo perto de zero. Isso costuma gerar oscilações ao redor do valor ideal.
Huber Loss: O Híbrido Robusto
Proposta pelo estatístico Peter J. Huber (1964), a Huber Loss combina as qualidades do MSE e do MAE. Ela utiliza um limiar ajustável chamado delta (δ).
Para |y - ŷ| ≤ δ:   L_Huber = 0.5 × (y - ŷ)^2
Para |y - ŷ| > δ:   L_Huber = δ × |y - ŷ| - 0.5 × δ^2
Quando o erro fica abaixo de delta, ela age como MSE e garante descida suave. Quando o erro supera delta, ela assume a linearidade do MAE e protege o modelo contra outliers. Essa fórmula fundamentou a Smooth L1 Loss usada em detecção de objetos.
Funções de Perda para Classificação: Cross-Entropy e Focal Loss
Funções de perda para classificação quantificam a discrepância probabilística entre classes previstas e classes reais. Elas se apoiam na teoria da informação para penalizar severamente respostas incorretas emitidas com alta confiança.
As bases da classificação probabilística nasceram com Claude Shannon (1948). A formulação foi expandida por Solomon Kullback e Richard Leibler (1951).
A entropia mede a incerteza de um evento. Já a divergência KL quantifica a distância informacional entre a distribuição verdadeira e o modelo estimado.
Binary Cross-Entropy (BCE / Log Loss)
A perda binária opera em tarefas com duas classes e ativação Sigmoid entre 0 e 1. Sua equação utiliza o logaritmo natural da probabilidade atribuída à classe correta:
L_BCE = - [y × ln(ŷ) + (1 - y) × ln(1 - ŷ)]
Se o rótulo é 1 e o modelo prevê 0.99, a perda é quase nula. Se o modelo insiste em 0.01, a penalidade tende ao infinito. Essa assimetria força a rede a corrigir certezas equivocadas com rapidez.
Categorical Cross-Entropy (CCE)
Em cenários multiclasse com ativação Softmax, a perda analisa a distribuição completa. A fórmula isola o logaritmo negativo da probabilidade da classe correta: L_CCE = - ln(p_c).
Se uma imagem de gato recebe probabilidade 0.85, a perda é baixa: -ln(0.85) ≈ 0.16. Se a previsão cair para 0.05, a perda sobe para -ln(0.05) ≈ 2.99. As demais classes participam da otimização através da normalização da camada Softmax.
Focal Loss: Solução para Classes Raras
Em conjuntos com desbalanceamento extremo, a Cross-Entropy convencional falha. Exemplos fáceis da classe majoritária geram gradientes pequenos individualmente, mas seu volume massivo asfixia o aprendizado.
Para superar essa barreira, Tsung-Yi Lin et al. (2017) criaram a Focal Loss. Ela inclui um fator modulador (1 - p_t)^γ que reduz a força de instâncias fáceis:
L_Focal = - (1 - p_t)^γ × ln(p_t)
Com o hiperparâmetro γ = 2, uma amostra com 90% de certeza tem sua perda reduzida em cem vezes. Os gradientes passam a se concentrar nas classes raras e difíceis.
| Função de Perda | Tipo de Problema | Camada de Saída | Sensibilidade a Outliers | Principal Vantagem |
|---|---|---|---|---|
| MSE (L2) | Regressão contínua | Linear / Identidade | Muito alta (quadrática) | Gradiente suave e analítico |
| MAE (L1) | Regressão robusta | Linear / Identidade | Muito baixa (linear) | Imunidade a valores extremos |
| Huber Loss | Regressão mista | Linear / Identidade | Moderada (híbrida) | Estabilidade no ponto ótimo |
| Binary Cross-Entropy | Classificação binária | Sigmoid | Média | Forte punição a erros confiantes |
| Categorical Cross-Entropy | Multiclasse exclusiva | Softmax | Média | Alinhamento com verossimilhança |
| Focal Loss | Classes desbalanceadas | Sigmoid / Softmax | Baixa | Foco seletivo em classes raras |
Funções de Perda em Modelos Modernos: Embeddings, Áudio e Alinhamento de LLMs
Modelos modernos utilizam funções de perda que vão além de rótulos tradicionais. Elas organizam espaços vetoriais, sincronizam áudio com texto sem marcação manual e ajustam modelos de linguagem com preferências humanas.
Sem essas formulações, o aprendizado auto-supervisionado em larga escala não existiria. Tecnologias como CLIP, Whisper e grandes modelos de linguagem operam sobre essas funções.
Contrastive Loss e InfoNCE em Embeddings
Na geração de embeddings, não existem classes rígidas. O objetivo é aproximar vetores de itens parecidos e repelir itens distintos. Esse método foi estruturado por Raia Hadsell, Sumit Chopra e Yann LeCun (2006).
O conceito evoluiu para a InfoNCE com Aaron van den Oord et al. (2018). A perda funciona como uma classificação entre um par positivo e milhares de negativos com temperatura τ:
L_InfoNCE = - ln [ exp(sim(q, k+) ÷ τ) ÷ Σ exp(sim(q, k_i) ÷ τ) ]
Essa perda maximiza a informação mútua entre representações latentes. Ela é a base de modelos de busca semântica e visão multimodal.
CTC Loss: Alinhamento Temporal em Áudio
Em reconhecimento de fala como no Whisper, o áudio tem milhares de quadros para poucas palavras. Não há marcações indicando o início e o fim de cada letra.
A Connectionist Temporal Classification (CTC Loss), de Alex Graves et al. (2006), soluciona essa questão. Ela introduz um token em branco (ε) e calcula a probabilidade de todos os alinhamentos válidos. O modelo aprende a sincronizar fala e texto sem anotações manuais.
DPO Loss: Alinhamento Direto de LLMs
O alinhamento clássico de LLMs exigia treinar um modelo de recompensa e rodar aprendizado por reforço com PPO. Esse fluxo consumia muita memória e apresentava instabilidades frequentes.
O trabalho de Rafael Rafailov et al. (2023) transformou essa prática com a Direct Preference Optimization (DPO). Os autores demonstraram que a política do próprio LLM pode atuar como modelo de recompensa:
L_DPO = - ln σ [ β × ln(π_θ(y_w|x) ÷ π_ref(y_w|x)) - β × ln(π_θ(y_l|x) ÷ π_ref(y_l|x)) ]
A perda aplica uma Cross-Entropy binária sobre a resposta preferida (y_w) contra a rejeitada (y_l). O cálculo compara a política com uma referência congelada (π_ref). O processo consome metade da memória VRAM e estabiliza o alinhamento.
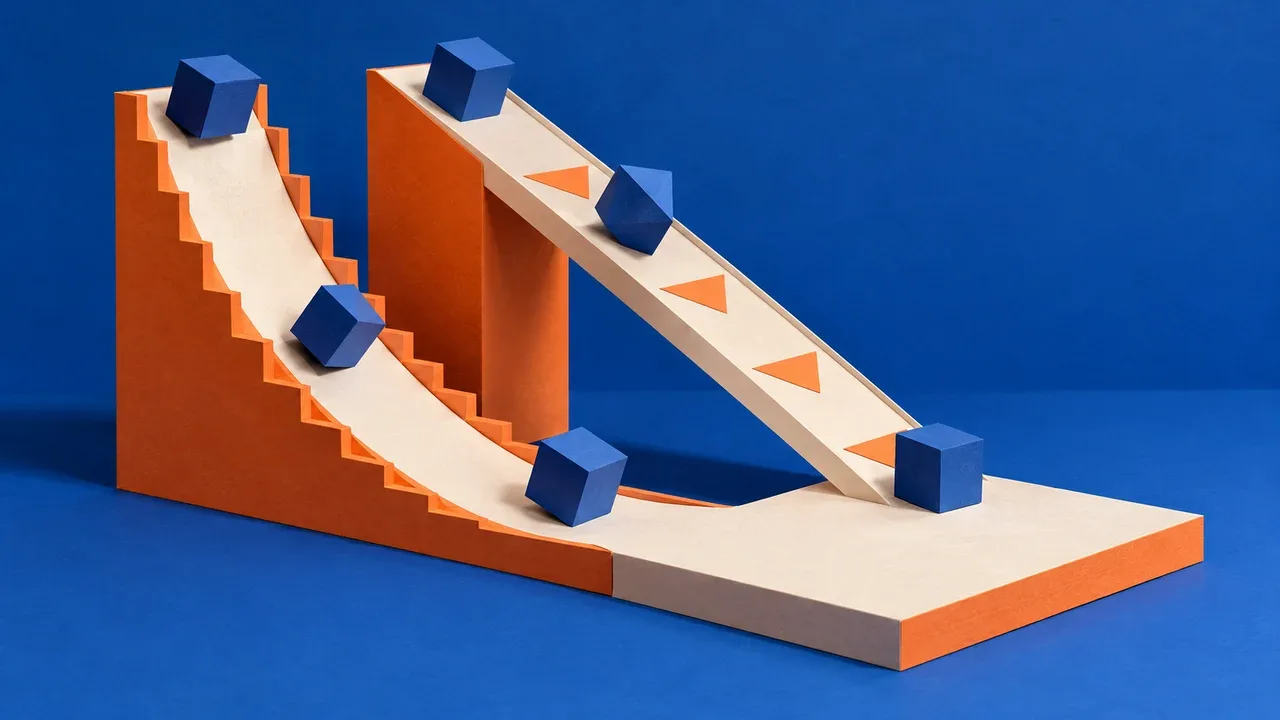
A Geometria do Loss Landscape e a Conexão com Otimizadores
O vetor gradiente da função de perda determina o tamanho e o sentido dos passos de atualização dos pesos. O backpropagation calcula as derivadas, e otimizadores como SGD e Adam guiam o modelo pela superfície de erro.
A forma geométrica dessa superfície define se o modelo converge bem ou fica preso em platôs. O estudo de Hao Li et al. (2018) mapeou a topologia de redes profundas.
Eles demonstraram que redes profundas sem conexões de atalho geram relevos caóticos. Em contrapartida, conexões residuais suavizam a paisagem, criando vales quase convexos de descida rápida.
Para evitar que a perda caia decorando ruídos da base, termos de regularização são somados à função de custo:
- Regularização L1 (Lasso): Soma o módulo dos pesos
λ × Σ |w_i|, zerando parâmetros irrelevantes e gerando matrizes esparsas. - Regularização L2 (Weight Decay): Soma o quadrado dos pesos
0.5 × λ × Σ w_i^2, impedindo pesos gigantescos e contendo o overfitting.
Essa combinação entre função de perda e termos de regularização garante generalização consistente para dados reais.
Como Implementar Funções de Perda no PyTorch
No PyTorch, funções de perda são módulos integrados sob o pacote torch.nn. Elas trazem rotinas em CUDA que garantem alta velocidade e estabilidade numérica nas GPUs.
O exemplo abaixo apresenta perdas para regressão e classificação, demonstrando a forma correta de usar logits brutos:
import torch
import torch.nn as nn

# 1. Regressao com MSE e Huber Loss
previsoes_reg = torch.tensor([12.5, 18.2, 9.1], requires_grad=True)
alvos_reg = torch.tensor([11.0, 19.0, 15.0])

criterio_mse = nn.MSELoss()
perda_mse = criterio_mse(previsoes_reg, alvos_reg)

criterio_huber = nn.HuberLoss(delta=1.0)
perda_huber = criterio_huber(previsoes_reg, alvos_reg)

print(f"Perda MSE: {perda_mse.item():.4f}")
print(f"Perda Huber: {perda_huber.item():.4f}")

# 2. Classificacao Multiclasse com Logits Brutos
# Saida do modelo sem passar por Softmax manual (truque log-sum-exp)
logits = torch.tensor([[2.4, 0.1, -1.2], [-0.5, 3.1, 0.8]], requires_grad=True)
rotulos = torch.tensor([0, 1])  # Classes alvo reais

criterio_cce = nn.CrossEntropyLoss()
perda_cce = criterio_cce(logits, rotulos)

# Ciclo padrao de retropropagacao
perda_cce.backward()
print(f"Perda Cross-Entropy: {perda_cce.item():.4f}")
print(f"Gradientes computados: {logits.grad}")
Um ponto fundamental de engenharia envolve a classe nn.CrossEntropyLoss. O PyTorch requer logits brutos na entrada, sem Softmax prévio.
A rotina interna une Softmax e perda usando o método matemático log-sum-exp. Isso evita problemas graves de ponto flutuante, como underflow e overflow na memória da GPU.
Critérios para Escolher a Função de Perda Certa
A escolha da função de perda depende do tipo de variável, da presença de anomalias e da camada de saída do modelo. Definir a perda correta evita semanas de retrabalho com treinos instáveis.
| Cenário de Negócio | Característica dos Dados | Função de Perda Recomendada |
|---|---|---|
| Previsão de Preços / Séries | Distribuição limpa e sem anomalias severas | Mean Squared Error (MSE) |
| Estimativa com Sensores Reais | Leituras com ruído e outliers ocasionais | Huber Loss (δ ajustado pelo IQR) |
| Diagnóstico Médico / Fraude | Classes extremamente desproporcionais | Focal Loss ou BCE ponderada |
| Visão Computacional Multiclasse | Classes mutualmente exclusivas | Categorical Cross-Entropy |
| Sistemas de Recomendação | Espaço latente de busca por similaridade | InfoNCE / Perda Contrastiva |
| Pós-treinamento de LLMs | Pares de preferências humanas (ganha/perde) | Direct Preference Optimization (DPO) |
Avaliar o problema antes de iniciar o treino assegura convergência rápida e métricas consistentes em produção.
Perguntas Frequentes sobre Funções de Perda em IA
Qual é a diferença fundamental entre função de perda e função de custo?
A função de perda avalia o erro de uma única amostra de treino. A função de custo calcula a média dessas perdas para o lote ou dataset inteiro. Na rotina prática de programação, os dois termos costumam ser usados com significado equivalente.
Por que não podemos usar acurácia diretamente como função de perda?
A acurácia é uma função descontínua que não possui derivadas informativas. Se a rede fizer pequenos ajustes nos pesos sem mudar a classe final, a acurácia permanece idêntica. Seu gradiente resulta em zero, impedindo a descida do gradiente.
Quando devo escolher Huber Loss em vez de MSE ou MAE?
A Huber Loss é indicada quando os dados contêm anomalias relevantes mas precisam de estabilidade perto do ótimo. Ela evita a punição quadrática explosiva do MSE sobre erros grandes. Ao mesmo tempo, supera as oscilações do MAE no ponto ideal.
Por que o PyTorch recomenda passar logits brutos para a CrossEntropyLoss?
A classe nn.CrossEntropyLoss executa Softmax e Negative Log-Likelihood em uma única operação interna em CUDA. Essa abordagem emprega o truque do log-sum-exp. O cálculo unificado previne problemas de underflow e overflow numérico.
Como a Focal Loss soluciona o desbalanceamento severo de classes?
A Focal Loss aplica o fator modulador (1 - p_t)^γ sobre a Cross-Entropy tradicional. Quando a rede classifica exemplos fáceis da classe majoritária, esse fator reduz drasticamente a perda. Com isso, os gradientes se voltam para as classes raras.
Por que o alinhamento de LLMs com DPO substituiu o PPO tradicional?
A perda DPO embute o modelo de recompensa diretamente na equação da política da linguagem. Isso dispensa o treinamento de redes secundárias de recompensa e algoritmos complexos de reforço. O ajuste passa a ser resolvido com uma otimização binária estável.
Para aprofundar seu estudo, leia nossos artigos sobre redes neurais e backpropagation. Veja também como aplicar o gradiente descendente. Na vertical MaxVision Labs, criamos arquiteturas e soluções completas para empresas em transformação digital com inteligência artificial.
