O aprendizado semi-supervisionado em IA junta poucos dados rotulados com muitos dados brutos. Essa técnica corta até noventa por cento dos gastos com anotação. O modelo ganha alta precisão sem meses de esforço manual.
Rotular dados à mão custa caro e atrasa projetos. Contratar pessoas para marcar milhares de itens eleva o risco financeiro.
Com esse método, a empresa usa o acervo que já tem no sistema. O time cria modelos sob medida com agilidade e baixo custo.
O que é aprendizado semi-supervisionado em inteligência artificial?
Aprendizado semi-supervisionado em inteligência artificial é a técnica que treina modelos usando poucos dados rotulados e muitos dados brutos. O método corta custos de preparação sem perder a precisão do sistema.
Em projetos comuns, o time precisa marcar cada foto, texto ou áudio antes do treino. Isso exige horas de trabalho de pessoas caras, como médicos ou advogados.
Esse método resolve o problema com inteligência. O modelo usa uma fatia pequena de dados revisados, entre um e dez por cento do total. Esse lote serve para fixar a meta do negócio.
Depois, o sistema lê o restante dos arquivos sem rótulo. Ele acha formas e regras comuns por conta própria.
A documentação oficial do Scikit-learn sobre aprendizado semi-supervisionado mostra como os dados brutos ajudam a traçar divisões seguras.
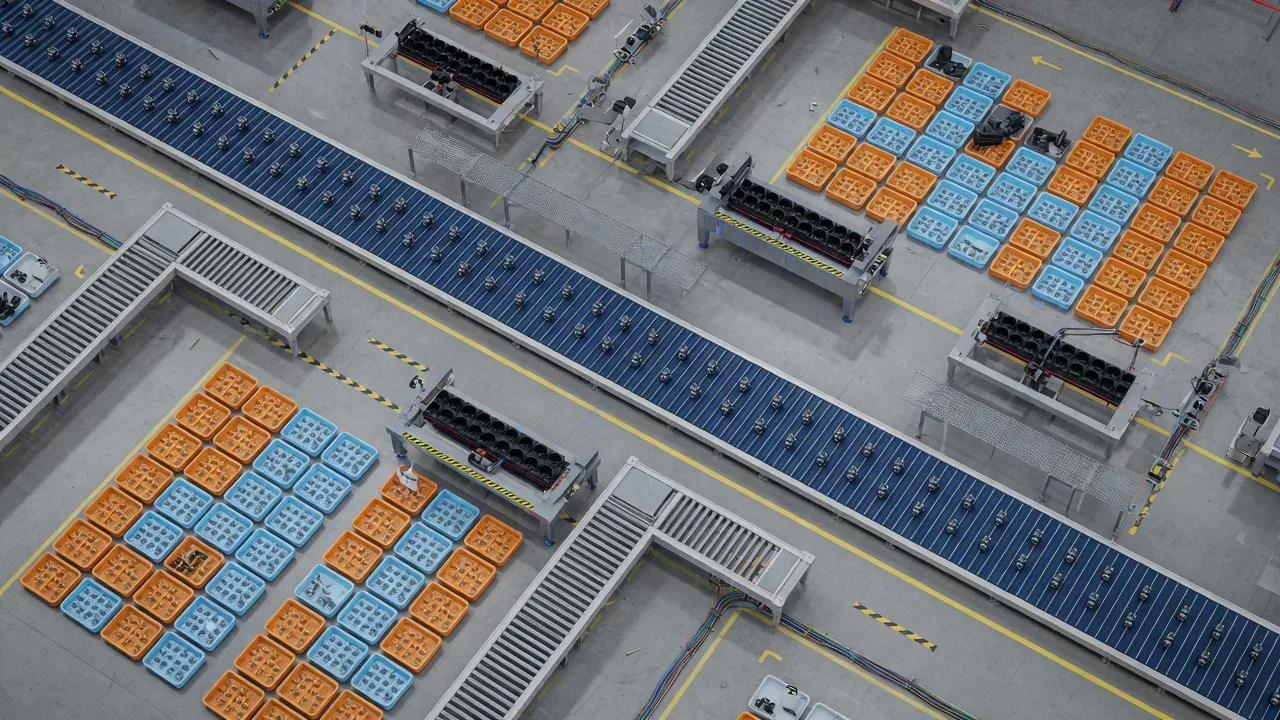
Pense em uma fábrica que checa peças na esteira. Em vez de pagar fiscais para olhar cem mil peças, ela marca quinhentas. A IA usa o restante para aprender variações normais de cor e luz.
Para quem decide as contas, isso viabiliza projetos sem estourar o caixa da empresa.
Como o modelo aprende usando dados que não foram rotulados?
O modelo aprende com dados não rotulados ao notar grupos e padrões naturais no arquivo bruto. Ele usa o teste inicial para prever novos casos e adotar só as respostas certas no treino.
A forma mais comum de fazer isso é a pseudo-rotulagem. O modelo começa aprendendo com o lote marcado por pessoas.
Em seguida, o robô avalia os itens sem rótulo. Quando ele tem certeza quase total, ele mesmo cria uma marca provisória para o dado.
O estudo de Lee sobre pseudo-rotulagem provou que essa regra ajuda a rede a separar classes com rigor.
Outro pilar forte é a regularização por consistência. A pesquisa do FixMatch, de Sohn et al. no arXiv, mostrou que pequenas mudanças no dado não devem alterar a previsão final.
O sistema cria uma versão alterada da foto, com leve giro ou corte de luz. Se a IA mantiver a mesma certeza, o dado entra no treino.
Soluções como o MixMatch de Berthelot et al. no arXiv mesclam dados para deixar o modelo mais estável.
Assim, o sistema ganha solidez sem exigir ajuda humana a cada passo do projeto.
Qual a diferença prática entre os tipos de aprendizado em IA?
A diferença prática está no esforço humano para marcar os dados antes de treinar o sistema. O modelo supervisionado pede cem por cento de marcas humanas. O semi-supervisionado usa menos de dez por cento, e o auto-supervisionado aprende sozinho no próprio texto.
Muitos líderes erram ao escolher o caminho técnico da empresa. A escolha errada atrasa a entrega e queima caixa sem necessidade.
No modelo supervisionado clássico, tudo depende de marcas manuais. Sem uma etiqueta em cada linha, o treino para.
No modelo auto-supervisionado, comum em grandes redes de texto, o sistema adivinha a próxima palavra lendo livros e páginas da web.
Já o modelo semi-supervisionado serve para quem tem dados próprios da empresa, mas não quer pagar anotações manuais caras.
A tabela abaixo compara os caminhos para quem decide investimentos na área:
| Critério de Decisão | Aprendizado Supervisionado | Aprendizado Semi-Supervisionado | Aprendizado Auto-Supervisionado |
|---|---|---|---|
| Volume rotulado | Cem por cento da base | De um a dez por cento | Zero marcas humanas |
| Custo de preparo | Muito alto com analistas | Baixo e previsível | Foco em poder de máquina |
| Melhor uso | Casos simples com poucos dados | Casos reais com dados brutos | Modelos de base e texto geral |
| Prazo de início | Lento pela marcação manual | Rápido com poucos exemplos | Exige grandes servidores |
Ao falar com parceiros de IA, pergunte como eles tratam seus dados antigos. O uso de técnicas mistas protege seu orçamento.
Quanto a empresa economiza ao usar aprendizado semi-supervisionado?
A empresa economiza entre setenta e noventa por cento dos custos ao adotar o aprendizado semi-supervisionado. O prazo do projeto cai de vários meses para poucos dias de trabalho.
Dados do relatório de mercado da Grand View Research mostram que a marcação de dados consome a maior parte dos gastos em IA.
Pense na análise de fotos médicas em uma rede de clínicas. Médicos cobram caro por hora para ver laudos e exames de pulmão.
Marcar cinquenta mil exames à mão custaria uma fortuna. Com esse método novo, os médicos olham só quinhentos casos com foco total. O restante do treino roda de forma automática sobre o arquivo antigo do hospital.
Mas a engenharia exige zelo para não criar erros em série. O risco central é o vício de confirmação, citado por Oliver et al. no arXiv.
Esse erro ocorre quando a IA cria um rótulo errado e passa a treinar sobre a própria falha.
Para evitar isso, o time impõe filtros duros. O sistema só aceita dados novos quando a certeza passa de noventa e cinco por cento. Casos com dúvida voltam para a mão de um especialista humano.
Na MaxVision Labs, criamos esteiras de IA seguras para gerar valor sem desperdício de caixa. Fale com o time da Produtora MaxVision e acelere sua empresa com suporte técnico de ponta.
Perguntas Frequentes sobre aprendizado semi-supervisionado
O que é a técnica de pseudo-rotulagem em inteligência artificial?
Pseudo-rotulagem é o ato em que a IA prevê marcas para dados brutos sem ajuda humana. Se a certeza da resposta for muito alta, essa previsão entra no treino dos passos seguintes.
Quando vale a pena investir em aprendizado semi-supervisionado?
Vale a pena quando sua empresa tem muitos dados brutos, mas marcar tudo à mão custa caro demais. O método é ótimo para triagem de notas, fotos de peças e suporte ao cliente.
O que é o vício de confirmação e como evitar esse erro?
Vício de confirmação é o erro em que a máquina gera uma marca falsa e treina sobre ela. Para evitar o problema, o time exige noventa e cinco por cento de certeza antes de aceitar o dado.
É possível usar essa técnica com fotos e com textos na empresa?
Sim, o método funciona muito bem tanto com fotos quanto com textos do negócio. Ele ajuda na inspeção de fábricas, na leitura de exames e no resumo de mensagens de clientes.