
A escolha entre IA self-hosted e API de nuvem define o futuro operacional da sua infraestrutura. A decisão apoia-se em quatro variáveis fundamentais: sensibilidade dos dados, orçamento previsível, capacitação da equipe técnica e nível de soberania exigido pela sua organização.
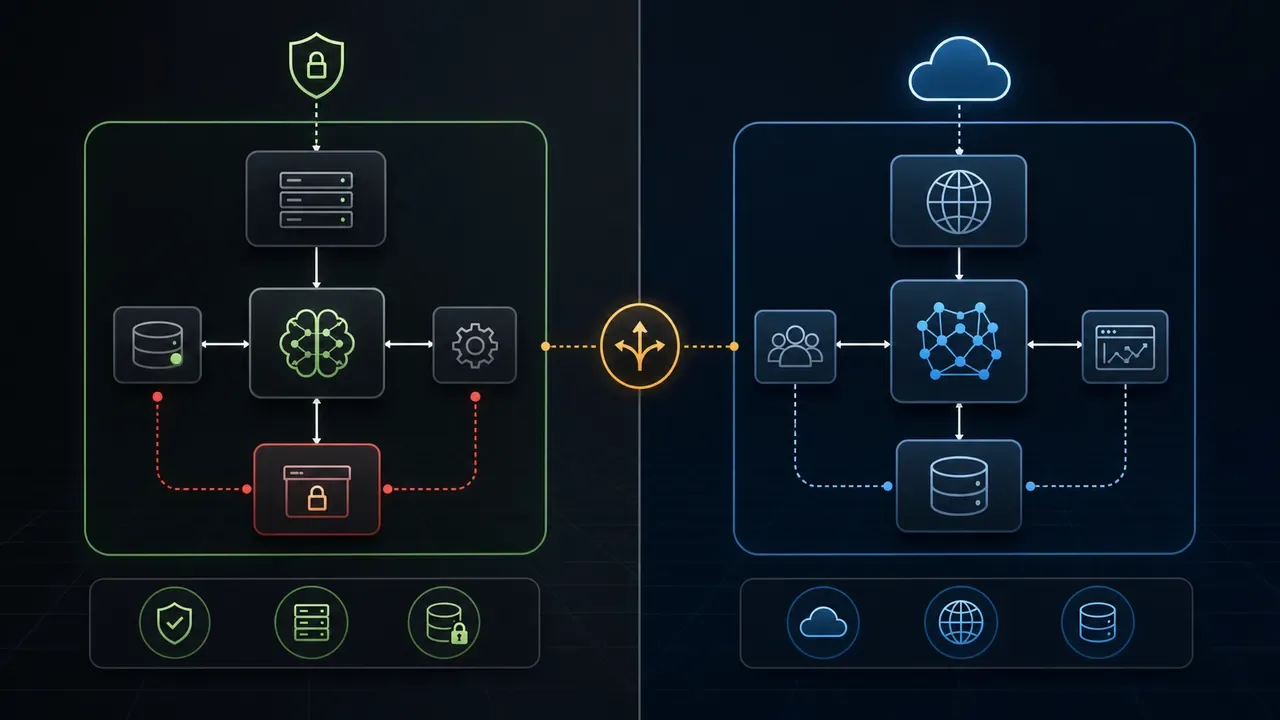
O que é, de fato, IA self-hosted?
Self-hosted significa que o modelo roda dentro de um servidor que você controla: pode ser um VPS, um servidor dedicado na sua empresa ou uma VM em cloud privada. O ponto central é que o dado não sai da sua infraestrutura para ser processado.
Ferramentas como o Ollama permitem inicializar LLMs locais com linha de comando e expor endpoints compatíveis com a OpenAI API. Quando a demanda exige alto throughput e batching otimizado, o vLLM torna-se o motor de inferência padrão para GPUs. Para busca semântica e RAG, extensões como pgvector e bancos dedicados como Qdrant mantêm os embeddings no perímetro local.
A stack típica em produção se parece com isto:
Cliente / Aplicação
       |
   API Gateway
       |
   Ollama / vLLM  <--- modelo rodando localmente
       |
   pgvector / Qdrant  <--- base de conhecimento
       |
   n8n / orquestrador  <--- workflows de automação
Se você ainda não conhece o n8n como orquestrador de fluxos, o artigo o que é n8n explica como ele conecta esses componentes sem exigir código extenso.
Por que tantas empresas ainda escolhem a nuvem?
A API de nuvem tem uma vantagem inegável: você começa a gerar valor no mesmo dia. Sem servidor para provisionar, sem modelo para baixar, sem infraestrutura para monitorar. Uma chave de API e alguns reais em crédito já colocam GPT-4o, Claude ou Gemini respondendo perguntas dos seus clientes.
Além da velocidade de entrada, os provedores de nuvem investem pesado em atualizações de modelo. Você não precisa gerenciar versões: quando o provedor lança uma melhoria, você automaticamente se beneficia.
Para protótipos, MVPs e empresas sem time técnico dedicado, essa frição zero é decisiva.
Qual é o real custo de cada caminho?
O custo de API de nuvem parece baixo no início, mas escala de forma imprevisível. Um chatbot que responde 50 mil mensagens por mês com contexto de 800 tokens por turno pode gerar facilmente R$ 2.000 a R$ 6.000 mensais dependendo do modelo escolhido. O custo é variável e indexado ao volume.
No self-hosted, o custo vincula-se à infraestrutura: servidores dedicados ou instâncias em nuvem privada. Uma GPU de 24 GB (como RTX 4090) atende modelos de até 30B quantizados; modelos de 70B exigem arranjos multi-GPU ou aceleradores de maior capacidade de memória. Acima de determinado volume de requisições, a previsibilidade da infraestrutura compensa o investimento.
A tabela abaixo consolida os principais trade-offs:
| Dimensão | IA Self-Hosted | API de Nuvem |
|---|---|---|
| Custo inicial | Alto (servidor, setup) | Baixo (pay-as-you-go) |
| Custo em escala | Previsível e fixo | Variável, escala com volume |
| Privacidade dos dados | Controle do perímetro | Dados trafegam para terceiros |
| Conformidade LGPD | Rastreabilidade direta | Exige DPA e auditoria do provedor |
| Latência | Depende do hardware local | Depende da distância ao datacenter |
| Qualidade do modelo | Limitada aos pesos abertos | Acesso aos modelos proprietários de ponta |
| Manutenção | Alta (updates, infra, segurança) | Baixa (gerenciado pelo provedor) |
| Controle de versão do modelo | Total | Limitado (provedor decide) |
| Disponibilidade | Operação e uptime sob sua gestão | SLA garantido pelo provedor |
| Customização (fine-tuning) | Flexível sobre pesos abertos | Limitada às opções do provedor |
Quando os dados sensíveis exigem self-hosting?
A LGPD não proíbe o uso de operadores terceiros, mas exige base legal, finalidade e medidas de segurança adequadas. Avalie contrato, transferência internacional e controles do provedor antes de classificar uma API como compatível.
Dados que tipicamente exigem self-hosting ou, no mínimo, contratos enterprise com garantias contratuais rígidas:
- Prontuários médicos e dados de saúde (sensíveis por definição na LGPD)
- Dados financeiros de clientes com detalhamento de transações
- Documentos jurídicos com informações de partes em litígio
- Conversas de RH envolvendo processos disciplinares
- Segredos industriais e propriedade intelectual
Se o seu produto processa qualquer uma dessas categorias de forma rotineira, a pergunta não é "self-hosted ou nuvem" — é "como estruturo o self-hosted para operar com segurança".
Quando a nuvem é a escolha racional?
Auto-hospedagem não é para todo mundo, e fingir o contrário seria desonesto.
Se o seu time não tem engenheiro capaz de administrar servidor Linux, configurar CUDA, monitorar GPU memory leak e aplicar patches de segurança, a vantagem de privacidade do self-hosted vira risco: um servidor mal configurado é pior do que uma API de nuvem bem configurada.
Cenários em que a nuvem provavelmente ganha:
- Volume baixo a médio com dados não sensíveis
- Time técnico pequeno ou sem especialização em infra
- Prototipagem e validação de produto
- Necessidade dos modelos de ponta (GPT-4o, Claude 3 Opus) sem equivalente open weight de qualidade comparável
- Prazo curto para entrar em produção
Existe um meio-termo?
Sim. O modelo híbrido é cada vez mais comum: dados sensíveis e queries que exigem privacidade vão para o modelo local; queries de baixo risco ou que exigem capacidade de raciocínio de ponta vão para a API de nuvem. O roteamento pode ser feito por regra simples no orquestrador.
Outra alternativa intermediária são serviços dedicados de nuvem (como Azure OpenAI ou AWS Bedrock). Eles oferecem modelos de fronteira em instâncias com isolamento contratual e sem retenção para treino, equilibrando facilidade de API com proteção de dados corporativos.
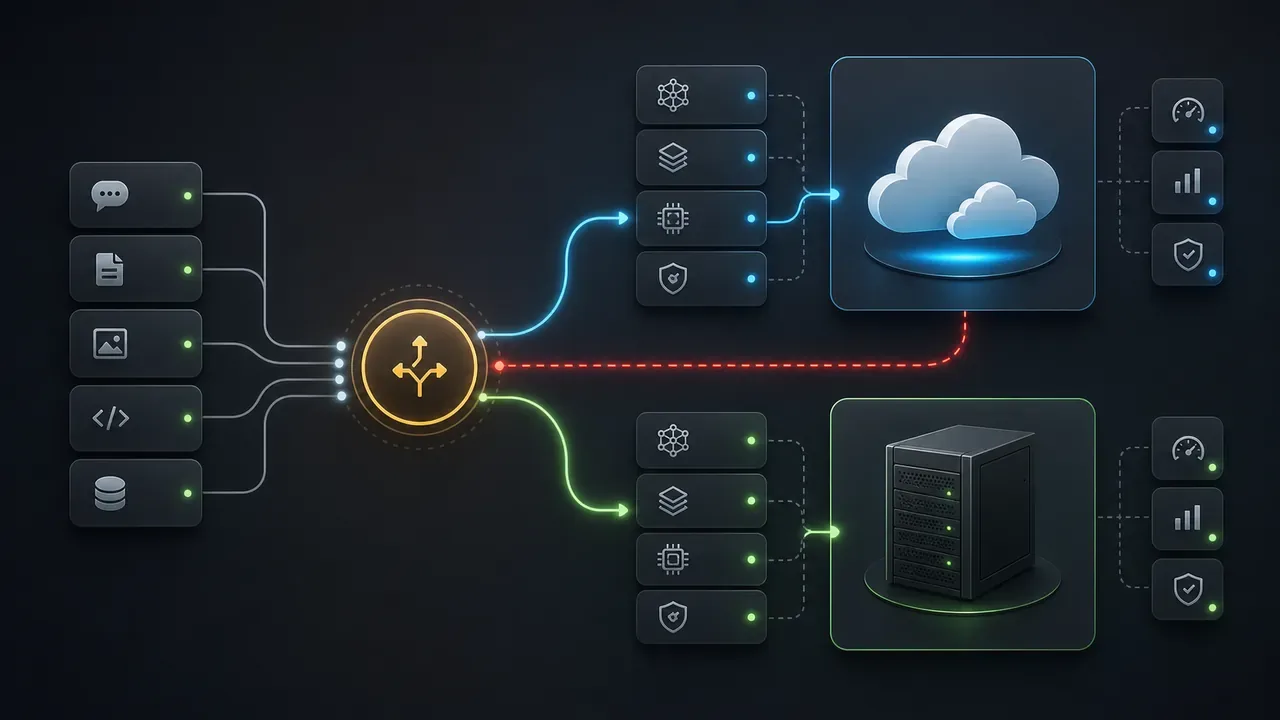
Como é na prática: a arquitetura de transição para self-hosting
Considere uma operação financeira ou jurídica que processa balanços, contratos e extratos. A transição da API para self-hosted normalmente ocorre em fases para mitigar riscos de interrupção:
- Validação de modelo: avaliação de LLMs de pesos abertos (famílias Llama ou Mistral) contra o benchmark interno de respostas da API.
- Ambiente de inferência: configuração de servidor com vLLM e banco vetorial pgvector ou Qdrant em rede privada isolada.
- Orquestração e esteira: implementação de monitoramento de latência e GPU antes do corte do tráfego de produção.
A vantagem reside na governança auditável sobre os dados e na blindagem contra oscilações de custos em grandes volumes.
Qual é a stack self-hosted mais usada?
Para quem está avaliando o caminho, os componentes mais maduros hoje são:
Serving do modelo:
- Ollama — ideal para desenvolvimento e operações de volume médio. Interface simples, funciona em CPU também (mais lento).
- vLLM — produção com GPU, throughput alto, suporte a batching.
Base vetorial para RAG:
- pgvector — se você já usa PostgreSQL, é a opção com menos overhead operacional.
- Qdrant — banco vetorial dedicado, mais recursos para casos avancados.
Orquestração de workflows:
- n8n self-hosted — conecta o modelo aos sistemas existentes (CRM, ERP, WhatsApp) sem código extenso. Veja mais em o que é n8n.
Observabilidade:
- Langfuse ou Phoenix para rastrear chamadas ao modelo, latência e custo por query.
Quais sinais indicam que é hora de migrar para self-hosted?
Alguns indicadores práticos que costumamos usar na avaliação:
- Custo mensal com API de nuvem cresce continuamente com o volume de chamadas
- Clientes ou auditores perguntaram onde os dados são processados
- A latência da API de nuvem gera experiência ruim em casos de uso real-time
- Você precisa de fine-tuning frequente e o custo no provedor inviabiliza iteração
- O modelo de nuvem foi atualizado pelo provedor e quebrou um comportamento que você dependia
Qualquer um desses sinais isolado pode não ser suficiente. Dois ou mais juntos geralmente justificam a avaliação formal.
Perguntas Frequentes
IA self-hosted é mais segura do que APIs de nuvem?
Depende da execução. Um servidor self-hosted bem configurado, com acesso restrito, criptografia em repouso e rede segmentada oferece controle superior. Um servidor mal administrado pode ser menos seguro do que uma API de provedor com SOC 2 Type II. A segurança não é propriedade intrínseca do self-hosting: é resultado de como você opera.
Quais modelos posso rodar em self-hosted?
Os principais são da família Llama (Meta), Mistral, Qwen (Alibaba) e Gemma (Google). A qualidade evoluiu muito: Llama 3 70B tem desempenho próximo ao GPT-4 Turbo em boa parte das tarefas. Para casos que exigem raciocínio complexo de ponta, os modelos fechados ainda levam vantagem.
Preciso de GPU para rodar self-hosted?
Não obrigatoriamente. Modelos menores (7B parâmetros) rodam em CPU, mas com latência alta para produção. Para uso em produção com latência aceitável, GPU é recomendada. Uma RTX 4090 já suporta modelos de 30B quantizados com boa performance.
Self-hosted é compatível com LGPD?
Self-hosted facilita a demonstração de conformidade porque você sabe exatamente onde os dados ficam e quem tem acesso. Mas conformidade vai além do armazenamento: envolve políticas internas, controles de acesso, logs de auditoria e processos para responder solicitações de titulares. O self-hosting é uma peça, não a resposta completa.
Quanto tempo leva para colocar self-hosted em produção?
Para um ambiente de desenvolvimento funcional com Ollama: algumas horas. Para produção estável com monitoramento, failover e pipeline de atualização de modelo: de duas a seis semanas dependendo da maturidade do time de infra e da complexidade da integração com sistemas existentes.
Conclusão
IA self-hosted e API de nuvem não competem: servem perfis diferentes. A nuvem vence em velocidade de entrada, manutenção reduzida e acesso aos modelos de ponta. O self-hosted vence em previsibilidade de custo em escala, soberania de dados e controle operacional.
A decisão mais inteligente começa com uma pergunta simples: quais dados vão passar pelo modelo? Se a resposta inclui categorias sensíveis, reguladas ou estratégicas, a conversa sobre self-hosting se torna obrigatória. Se os dados são genéricos e o time é pequeno, a nuvem provavelmente entrega mais valor com menos fricção.
O que não recomendamos é adiar a decisão por não ter clareza sobre o assunto. Cada mês de uso desatento de API de nuvem com dados sensíveis é um risco regulatório acumulado.
O departamento de DevOps e IA Self-Hosted da MaxVision provisiona e opera a stack de inferência local no seu ambiente. Avaliamos também arquiteturas híbridas via Inteligência Artificial. Para estruturar sua operação, entre em contato.
